 bukatchuk
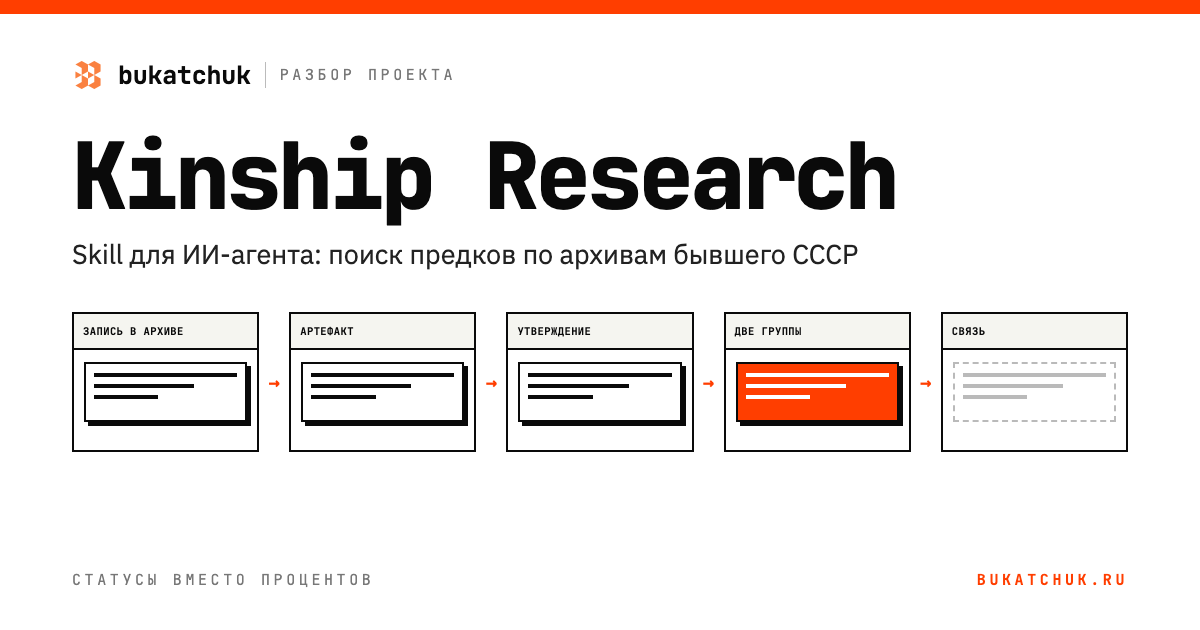
В семейной истории обычно есть одна фраза, которую все знают и никто не может доказать: прадеда сослали в Казахстан, бабушка родом из-под Каменец-Подольского, фамилию записали с ошибкой. Дальше начинается работа, к которой мало кто готов: село называлось иначе и входило в другую губернию, книга лежит в другом государстве, а скан без индекса нужно читать глазами на дореформенном русском. Проект ex-USSR Kinship Research поручает эту работу ИИ-агенту и обещает главное, чего от него ждёшь меньше всего: не выдумывать родственников.
Репозиторий появился 25 октября 2026 года, а через неделю у него 1403 звезды, 147 форков и журнал на 30 выпусков. Я прочитал инструкции, справочники и скрипты версии 1.30.0 (коммит 92113ea от 31 октября 2026 года), пересчитал цифры и сравнил README с кодом. Сам skill и его тесты я не запускал: всё ниже взято из файлов и истории репозитория.
Меня интересовали три вопроса: как текст для модели превращается в метод исследования, что на самом деле проверяет скрипт аудита и что происходит с семейными документами. На второй вопрос ответ оказался скромнее, чем в README, и от него зависит вывод в конце.
Что это и из чего состоит
Skill — это папка с инструкциями, которую агент с доступом к файлам и командной строке читает, когда задача подходит под её описание. Здесь такая папка содержит главный файл, большую справочную часть и небольшой набор скриптов. Текста здесь в разы больше, чем кода: 743 килобайта инструкций против 2041 строки Python.
| Часть | Где лежит | Объём |
|---|---|---|
| Главные инструкции | SKILL.md |
284 строки, 54 860 байт |
| Справочники | references/, 21 файл |
688 456 байт |
| Скрипты | scripts/, 10 файлов на Python |
2041 строка |
| Модульные тесты | tests/, 6 файлов |
1306 строк, 84 теста |
| Сценарии для проверки рассуждений | evals/, 10 файлов |
140 сценариев |
| Шаблоны дела | assets/ |
11 файлов |
Инструкции написаны по-русски, но первая же секция SKILL.md требует отвечать на языке пользователя. Запросы к архивам агент составляет на языке источника, цитаты приводит в оригинальном написании. README есть на 19 языках, включая языки всех республик.
Темп у проекта необычный. За неделю в нём 327 коммитов: 197 обычных и 130 слияний. Обычные коммиты сделали 30 человек, у автора Дениса Ширяева 75, у второго участника 27. Значительная часть работы — чужие дополнения: региональные архивы, чеченская депортация, принудительные работники в Германии, Бессарабия. Выпуски выходят почти каждый день; к этому я вернусь в разделе о рисках.
Как работает исследование
SKILL.md описывает 12 шагов: зафиксировать вопрос, завести дело, разобрать материалы, построить историческую географию, составить план, искать, оценить находки, разрешить личности, проверить цепочку родства, провести аудит, написать вывод и отчёт. Перед шагами стоят 11 правил, которые нельзя нарушать.
Два из них задают весь проект:
Считать любой новый материал артефактом, а не фактом.
Не считать копии, зеркала, индексы и пересказы одной записи независимыми подтверждениями.
Агенту также предписано работать автономно, «при необходимости многочасовом цикле», и не спрашивать «продолжать?» после каждого этапа. Если нужна капча или вход, блокируется только этот маршрут, а поиск идёт дальше по другим источникам. Для долгой задачи это разумно: иначе агент остановится на первом закрытом сайте.
Историческая география решена так: событие привязывается к государству, губернии, уезду и приходу на дату события, а не к современной карте. Поэтому поиск начинается не с современной области, а с того, какому органу подчинялось село в год события. Для 1944–1957 годов в Чечне отдельный справочник велит записывать юрисдикцию так, как она указана в источнике: Грозненская область, Дагестанская АССР и другие.
Реестры доказательств: ключевое решение
Самое интересное решение проекта — не в тексте, а в структуре данных. Память агента вынесена в пять CSV-файлов в папке дела: лица, артефакты, утверждения, связи и журнал поиска. Модель не держит родословную в контексте и не пересказывает её своими словами. Каждый вывод должен иметь строку, а у строки есть источник.
Заголовок реестра утверждений:
claim_id,claim_text,subject_person_ids,claim_type,artifact_ids,
supporting_independence_groups,contradicting_artifact_ids,status,
confidence,rationale,next_action
Вместо вероятностей используются шесть статусов: hypothesis, single-source, corroborated, strongly-corroborated, contradicted, unresolved. Проценты запрещены прямо: confidence принимает только low, moderate и high и не заменяет статус. Я считаю это правильным решением, потому что «87% вероятности, что это ваш прадед» выглядело бы точнее, чем есть на самом деле.
Центральное понятие — independence_group. Метрическая запись, её индекс на сайте и копия в чужом дереве получают одну группу и считаются одним подтверждением. Статус corroborated требует двух независимых цепочек. Даже сильный первичный документ до этого остаётся single-source. Одноимённые люди живут под разными person_id, пока не появится различающий признак: номер дома, родители, восприемники, точная дата рождения.
Хорошо продумано и обратное направление. Отсутствие результата не считается доказательством отсутствия человека. Если сайт недоступен, это не отрицательный результат, а заблокированный маршрут. Несколько чтений одного скана людьми, моделями или OCR остаются одной цепочкой и не создают новую группу.
Что на самом деле проверяет аудит
README обещает:
Группа независимости учитывается только тогда, когда к ней относится процитированный артефакт: простым присвоением статуса подтверждение создать нельзя.
Скрипт audit_evidence.py на 453 строки действительно ловит многое: несуществующие ссылки, дубли ID, сдвинутые колонки CSV, группу в утверждении, за которой не стоит артефакт, неизвестные номера в отчёте. Вопрос в том, что происходит, когда статус не подкреплён. Вот проверка:
if status in CORROBORATED and len(groups) < 2:
    warnings.append(
        f"{claim_id}: статус {status}, но найдено независимых групп: {len(groups)}"
    )
И конец функции main:
if errors:
    return 1
if warnings and args.strict:
    return 1
return 0
По коду выходит, что утверждение со статусом strongly-corroborated на одной группе даёт предупреждение и код возврата 0. Флаг --strict это меняет, но он не упомянут ни в SKILL.md, ни в README, ни в справочниках. Шаг 10 велит запускать аудит без него и разбирать предупреждения по источникам. Итог проверки зависит от того, как агент отнесётся к предупреждению. Статус присвоить можно, просто об этом будет сказано.
Вторая граница важнее. Группа — это метка в ячейке. Если записать копии одного документа разные метки, скрипт насчитает две независимые цепочки. Он не может знать, что G1 и G2 восходят к одной метрике. Проект об этом честно говорит в evidence-protocol.md: скрипт «считает разные метки у связанных артефактов, не проверяя происхождение каждого сведения». Описание в начале файла тоже точное: Audit cross-references and corroboration claims without assigning truth. Аудит проверяет согласованность записей, а не истину. README формулирует это сильнее, чем код.
Третья граница — отчёт. README говорит, что скрипт проверяет итоговый отчёт, но читает он только final-report.md, и если файла нет, проверка молча пропускается. А шаг 12 называет итоговым отчётом по умолчанию report.html, который скрипт не открывает. В SKILL.md прямо сказано сверять HTML с реестрами «средствами агента». Значит, документ, который получит семья, сверяет с реестрами тот же агент, который их заполнял. В тексте final-report.md проверяются ID и статусы в таблицах и в первой строке раздела; статус, упомянутый в свободной фразе, сверку не проходит.
Мне это не кажется дефектом замысла. Механическая проверка независимости источников невозможна, и авторы её не изображают. Но читать вывод corroborated нужно как «агент так решил и оформил аккуратно», а не как «программа это подтвердила».
Каталог источников
Самый большой файл проекта — seed-sources.md, 218 608 байт. В его таблицах 191 строка, и каждая отнесена к классу надёжности.
| Класс | Что значит | Строк |
|---|---|---|
| A | институциональный, официальный | 111 |
| B | репутационный индекс, тематический проект | 50 |
| C | сообщество, наводка, родство не подтверждает | 22 |
| Q | карантин, как доказательство не использовать | 8 |
Разделы идут по темам и регионам: архивы, репрессии, Украина, Беларусь и Молдова, Балтия, Кавказ и Центральная Азия, еврейские семьи, военные источники, эмиграция и плен. Есть и правило добавления: указать владельца, юрисдикцию, происхождение, дату проверки и отмечать пробелы, а не угадывать. Охват неровный. В справочниках слово «Туркмен» встречается 4 раза, «Таджик» — 3 раза, тогда как материалы по России, Украине и Чечне написаны подробно. Обещание покрыть все 15 республик в README сопровождается оговоркой, что региональный пример не заменяет местного исследования.
Ссылки каталога я не проверял, поэтому сказать, сколько из них живых, не могу. Для части строк в файле стоит дата наблюдения участника: это хорошая практика, потому что такие сведения быстро устаревают.
Сеть и безопасность
В Python-скриптах сеть нужна только одному помощнику. gwar.py обращается к порталу о Первой мировой войне gwar.mil.ru; остальные скрипты разбирают локальные файлы. Весь прочий поиск идёт через браузер или поиск самого агента, и этот трафик из кода не виден.
Клиент сделан аккуратно. Интервал между запросами 0,4 секунды, на 401, 403 и 429 он сразу останавливается, а редирект на другой адрес считается ошибкой. Чтобы достучаться до GWAR, рядом со скриптами лежат два сертификата Russian Trusted CA Минцифры:
# Extra certificates apply only to this client, never to the system trust store.
context = ssl.create_default_context()
for name in ("russian_trusted_root_ca.pem", "russian_trusted_sub_ca.pem"):
    path = Path(__file__).resolve().parent / "ca" / name
Сертификаты подключаются только к этому HTTPS-клиенту, а адрес BASE в нём зашит. Системное хранилище не меняется, проверка TLS не отключается. Я проверил сроки: корневой действует до февраля 2032 года, промежуточный — до 19 июля 2029 года. Если цепочка перестанет сходиться, запрос по коду завершится ошибкой TLS, а не снизит защиту.
С FamilySearch проект держит дистанцию. Скрипт не ходит на сайт: он разбирает сохранённые агентом фрагменты и проверяет, что у них устойчивая ссылка на familysearch.org. Справочник напоминает, что условия сервиса требуют письменного разрешения на массовое получение данных. browser-import откажется от записи «индекса нет», если в ней нет текста источника, который это подтверждает. build_pdf.py запускает браузер с запретом разрешения имён и отклоняет активный HTML, так что отчёт при сборке PDF в сеть не ходит.
С CAPTCHA решение спорное. Агенту разрешена одна попытка пройти проверку через обычный интерфейс браузера, причём без дополнительного разрешения пользователя. Внешние решатели, подмена отпечатков, прокси и обход лимитов запрещены. Но CAPTCHA как раз и ставится, чтобы отсеять автоматические запросы, и даже одна попытка программы идёт против её назначения. Я бы сразу передавал этот шаг человеку.
Самый заметный пробел — приватность. Правило 8 запрещает загружать документы, ДНК-данные и фотографии «в сторонние сервисы» без явного разрешения. Но в privacy-and-safety.md я не нашёл ни слова о том, что сам агент может работать через облачную модель, и тогда сканы метрик и семейные фото уходят её поставщику уже при чтении. Для исторических записей это обычно неважно. Для документов об усыновлении или результатов ДНК живых родственников это важно, и решать должен человек до запуска, а не после.
Письма и запросы от имени пользователя
Отдельный шаг 6б посвящён запросам в архивы, библиотеки и университеты. Агент может отправлять их сам, если подключена почта и пользователь разрешил. Правила жёсткие: само подключение ящика разрешением не считается, просьба «подготовить проект» отправку не разрешает, пароли в чат не просят, платные услуги начинаются только после отдельного согласования. После отправки агент должен прочитать письмо в «Отправленных» и сверить адресатов, текст и вложения.
В этом месте написано лучше, чем у многих агентских инструментов. И всё же это текст для модели, а не проверка в коде. Запрета на уровне программы нет.
Установка и запуск
Есть два способа:
npx skills add https://github.com/DenisSergeevitch/ex-ussr-kinship-research
git clone https://github.com/DenisSergeevitch/ex-ussr-kinship-research <папка навыков агента>
Оба берут текущее состояние главной ветки: привязки к версии нет. После установки дело заводится вне папки навыка, и init_case.py откажется создавать его внутри, даже с --force:
python scripts/init_case.py --case-dir ~/kinship-cases/my-case \
  --research-question "Who were Maria's parents?" --subject-label "Maria"
python scripts/audit_evidence.py --case-dir ~/kinship-cases/my-case
Работает защита и от случайной публикации: в .gitignore стоят типичные названия папок дел. После запуска постоянных процессов не остаётся, это обычные короткие скрипты.
Лицензии
Корневая лицензия MIT. Зависимостей в манифесте нет, потому что нет и самого манифеста. Необязательные Pillow и pypdfium2 ставит пользователь, зафиксированных версий у них нет. В бинарном виде поставляются только шаблон .docx и обложка; всё остальное читается как текст.
Один вопрос остаётся открытым. В ww1-search.md сказано, что поисковая часть GWAR адаптирована из russian-archives/scripts/gwar.mjs. Ссылки на этот проект и сведений о его лицензии в репозитории я не нашёл. Отдельно стоит помнить, что MIT относится к коду и инструкциям, а у архивных материалов и сайтов из каталога свои условия. Для части строк в файле прямо написано: лицензия не указана.
Расхождения README с репозиторием
При таком темпе документация отстаёт. Я сверил русский README с файлами:
| README | Репозиторий |
|---|---|
в assets/ есть report-pdf.template.html |
файла нет, есть report.template.html |
в references/ перечислено 19 файлов |
файлов 21: нет research-coordination.md и search-result-validation.md |
| скриптам нужны только Python 3 и стандартная библиотека | scan_montage.py требует Pillow, README его не упоминает |
указан один файл evals/discovery-and-logic.yaml |
файлов 10, в нём 81 сценарий из 140 |
| 17 ссылок на другие языки | в английском 18: японский добавили только туда |
Все расхождения мелкие и на работу не влияют, но помогают понять темп проекта. Да и User-Agent клиента до сих пор представляется версией 1.6.
Ограничения и риски
- Сценарии не исполняются. Файлы в
evals/сами себя называют условными ситуациями «для содержательной проверки, не автоматические unit-тесты». 84 модульных теста проверяют скрипты, а поведение модели не проверяется ничем воспроизводимым. Настроек CI в репозитории нет. - Качество зависит от модели. Чтение дореформенного почерка в скане, разбор имён и решение о двух группах выполняет не код. Проверить это по исходникам нельзя.
- Инструкции обновляются быстро. В начале исследования агент сверяется с репозиторием и предлагает обновление с согласия пользователя. За неделю вышло 30 версий, а обновляемый текст управляет агентом с браузером и, возможно, с почтой. Перед обновлением я бы смотрел разницу, а установку закреплял на коммите.
- Правила держатся на добросовестности агента. Запрет искать адреса живых людей и обещание минимизировать данные написаны текстом. Это снижает риск случайного поведения, но не мешает модели ошибиться.
- Персональные данные. Даже без слежки дело содержит имена, даты, а иногда сведения о репрессиях и усыновлении. Папку дела нужно защищать как обычные чувствительные документы.
Кому подойдёт
Проект подойдёт тому, кто ищет своих предков, готов читать результат критически и понимает, что corroborated — это заявка на проверку, а не вердикт. Хорошо он подойдёт и генеалогу как ассистент для рутины: варианты имён, поиск нужной книги, журнал проверок, черновик запроса в архив. Здесь его журнал поиска, пожалуй, ценнее самого поиска.
Не подойдёт тому, кто хочет готовое семейное древо без проверки, и тому, кому нужен юридически значимый документ о родстве. Осторожнее стоит быть с делами о живых людях и с чувствительными документами, особенно если модель работает в облаке.
Главное, что я бы забрал отсюда даже без генеалогии, — приём с реестрами. Вместо просьбы к модели «будь аккуратна» проект заставляет её раскладывать вывод на строки с источниками, которые можно пересчитать. Модель всё равно может ошибиться, но ошибка теперь лежит в конкретной ячейке, и её можно найти. Проверять отчёт я бы начинал не с текста, а с реестра утверждений и журнала поиска.