 bukatchuk
В 2018 году в моём списке вопросов для собеседований был такой: «Как сохранить правило в iptables, чтобы после перезагрузки оно не затёрлось?» И ответ к нему, целиком: «Нужно ввести команду iptables-save». Тридцать пять символов. И они неверные: iptables-save ничего не сохраняет, она печатает правила в stdout. Восемь лет этот ответ лежал в открытом репозитории, собрал 20 звёзд и 15 форков, и кто-то по нему, вероятно, готовился.
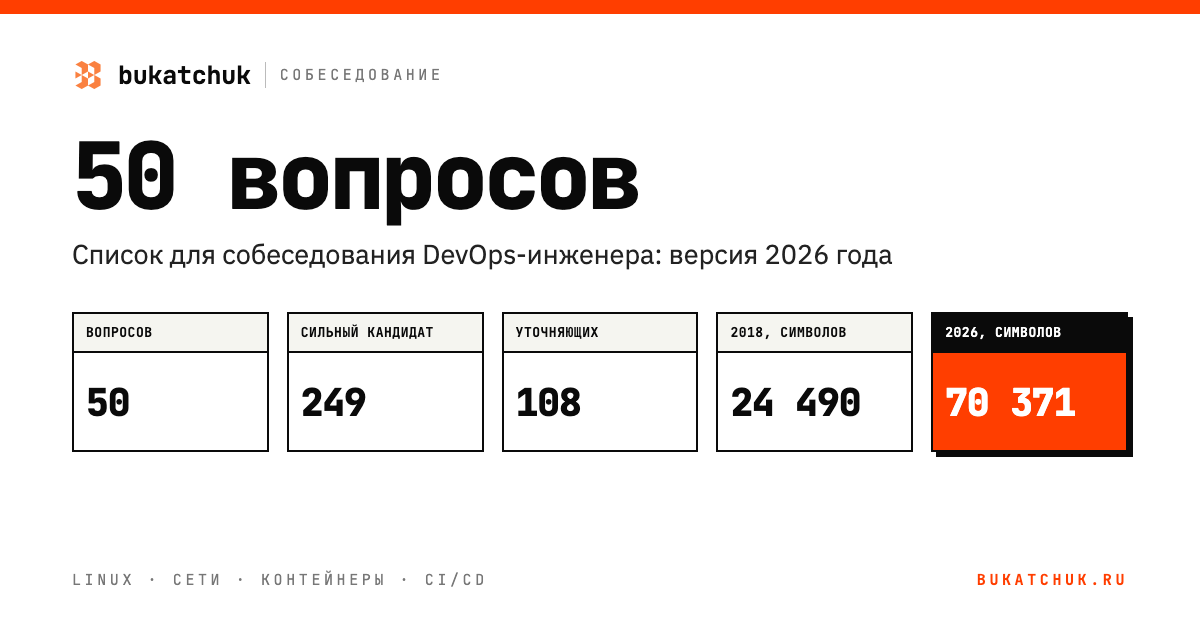
В октябре 2026 года я переписал список целиком. Вопросов по-прежнему пятьдесят, но текст вырос с 24 490 символов до 70 371, а у каждого ответа появилась структура. Ниже — что получилось: как устроен ответ, какие вопросы не пережили восемь лет, на каких лучше всего виден уровень инженера и как этим пользоваться, если вы сидите по любую сторону стола.
Для статьи я сравнил версию 2018 года с текущей по истории Git и пересчитал обе: все цифры ниже — из файлов, а не по памяти.
Что это за список
Один файл README.md, 952 строки. Пятьдесят вопросов для собеседования DevOps-инженера или администратора Unix. Задача описана в первой строке: за одно интервью понять уровень инженера.
Это не шпаргалка «выучи и пройди». Список написан для того, кто спрашивает. Отсюда формулировки на «ты» и отсюда же структура ответа, о которой дальше.
По темам вопросы распределены так — разбивка моя, в самом файле разделов нет, вопросы идут вперемешку:
| Тема | Вопросов | Примеры |
|---|---|---|
| Сети | 13 | DNS, CIDR, TCP и UDP, TLS, VXLAN, OSPF и BGP |
| Linux и ОС | 11 | inodes, Load Average, PID 1, зомби, swap, SELinux |
| Процессы и практики | 8 | IaC, CI/CD, GitOps, observability, нагрузочные тесты |
| Контейнеры и оркестрация | 6 | контейнер против ВМ, Kubernetes, OCI и CRI, Helm |
| Программирование | 5 | типизация, конкурентность, компиляция, LIFO и FIFO |
| Данные | 4 | типы баз, типы хранилищ, MapReduce, ORM |
| Виртуализация | 2 | виды виртуализации, KVM и Xen |
| Кругозор | 1 | вопрос номер 50 |
Перекос в сторону сетей и Linux заметный, и я считаю его оправданным. Интерфейс очередного инструмента осваивается по документации. Понимание того, почему LA 40 при пяти процентах загрузки CPU, из документации к инструменту не берётся.
Как устроен ответ
В 2018 году ответ был абзацем текста, иногда строкой. Самый короткий занимал 32 символа. По такому ответу можно сверить одно: назвал кандидат правильное слово или нет.
Теперь у каждого из пятидесяти ответов три части:
- Короткий ответ — минимум, который ожидается от кандидата.
- Сильный кандидат добавит — детали, по которым видно глубину и практический опыт.
- Уточняющие вопросы — куда копать дальше, если базовый ответ получен.
Всего в списке 249 пунктов «сильный кандидат добавит», от трёх до семи на вопрос, и 108 уточняющих вопросов, по два-три на каждый.
Вот как это выглядит на вопросе про Load Average. Короткий ответ — определение и главная оговорка: значение не нормировано, его сравнивают с числом ядер. Дальше:
**Сильный кандидат добавит:**
- Высокий LA при низкой загрузке CPU указывает на ввод-вывод: медленный диск, зависший NFS.
- Три числа показывают тенденцию: нагрузка растёт или спадает.
- Источник — `/proc/loadavg`; дальше смотрят `vmstat`, `iostat`, `pidstat`.
- PSI (`/proc/pressure/cpu`, `io`, `memory`) точнее: показывает долю времени,
  которую задачи простаивали из-за нехватки ресурса.
- В контейнере LA отражает весь хост. Для контейнера смотрят throttling в cgroup (`cpu.stat`).

**Уточняющие вопросы:**
- LA 40 на четырёх ядрах, CPU загружен на 5 %. Что проверять?
- Почему сервис в контейнере тормозит, хотя LA на ноде низкий?
Три части дают три ступени. Кандидат, который знает определение, остановится на первой. Кандидат, который разбирался с тормозящим сервером, сам дойдёт до ввода-вывода. А вопрос про контейнер отделяет тех, кто работал с cgroup, от тех, кто о них читал.
Мне эта структура нравится тем, что она снимает главную проблему собеседования — «он вроде всё правильно сказал, но я не понял, какого он уровня». Уровень виден по тому, на какой ступени человек замолчал.
Что изменилось за восемь лет
Список 2018 года читается как снимок эпохи. В нём был вопрос про RVM, про отличия Python 2 от Python 3 и про стек MEAN. Kubernetes упоминался дважды на весь файл.
Пять вопросов я заменил полностью:
| № | Было в 2018 году | Стало в 2026 году |
|---|---|---|
| 11 | Что такое RVM? | CI, Continuous Delivery и Continuous Deployment, стратегии выкладки |
| 12 | Главное отличие Python 2 от Python 3 | Что такое GitOps? |
| 14 | Что такое стек MEAN? | Observability и стек наблюдаемости |
| 23 | Какие текстовые редакторы в Unix ты знаешь? | Как работает DNS? |
| 40 | Виды доступа по SMB/CIFS и Samba | Блочное, файловое и объектное хранилище |
Вопрос про редакторы был самым лёгким в списке, а ответ на него занимал 39 символов. DNS на его месте полезнее: в ответе разобран весь путь разрешения имени.
Ещё часть вопросов осталась на месте, но поменяла формулировку. По ним видно, как сдвинулась отрасль:
- Номер 2 был про iptables, стал про iptables и nftables.
- Номер 16 спрашивал про отличие ВМ от «Docker-контейнера», теперь — просто от контейнера.
- Номер 27 сравнивал RHEL, CentOS, Debian и Ubuntu. Теперь в нём отдельный подвопрос: «Что случилось с CentOS?»
- Номер 29 просил назвать «альтернативу Docker». Теперь спрашивает про OCI и CRI.
- Номер 33 был «Что такое Vagrant?». Теперь это вопрос про воспроизводимое локальное окружение, с припиской «нужен ли он сегодня».
- Номер 48 был про Xen, теперь про KVM и Xen. Номер 49 — про OSPF, теперь про OSPF и BGP.
То же самое в цифрах. Я посчитал, сколько раз названия встречаются в файле:
| Слово | 2018 | 2026 |
|---|---|---|
| Kubernetes | 2 | 29 |
| Docker | 11 | 20 |
| Ansible | 1 | 10 |
| nftables | 0 | 8 |
| Terraform | 1 | 6 |
| systemd | 0 | 6 |
| containerd | 0 | 5 |
| cgroup | 0 | 5 |
| OpenTofu | 0 | 4 |
| CentOS | 6 | 6 |
CentOS упоминается столько же раз, сколько и раньше. Только теперь это рассказ о том, как его не стало: поддержка CentOS 8 закончилась в конце 2021 года, CentOS 7 — в июне 2024 года, а место заняли Rocky Linux и AlmaLinux.
А вот что не изменилось вовсе: inodes, sysctl, RAID, xargs, sed, зомби-процессы, swap, TCP и UDP. Формулировки этих вопросов я не тронул. Ответы выросли в несколько раз, но спрашиваю я то же самое, что и восемь лет назад. По-моему, это и есть главный вывод из всей переделки: инструменты сменились почти все, а фундамент остался.
Вопросы, на которых виден уровень
Не все пятьдесят одинаково полезны. Вот четыре, которые я считаю самыми показательными, вместе с тем, почему.
Номер 2, тот самый, про iptables. Ответ «iptables-save» — это уже полезный сигнал: человек помнит команду, но не помнит, что она делает. Правильный короткий ответ — записать вывод в файл и восстановить при загрузке, и способ зависит от дистрибутива. Сильный кандидат добавит, что iptables в современных системах — это обычно iptables-nft, а Docker и kube-proxy сами управляют правилами и с ручными правками конфликтуют.
Номер 24, про CIDR. Единственный вопрос, где нужно считать и писать:
/29 → 32 − 29 = 3 бита → 8 адресов → 6 хостов → 255.255.255.248
Первый адрес — адрес сети, последний — широковещательный, поэтому хостов шесть. Уточняющие вопросы там такие: назвать адрес сети и широковещательный адрес для 10.0.5.130/26 и сказать, сколько сетей /24 помещается в /20. Для самопроверки: 10.0.5.128, 10.0.5.191 и шестнадцать. Арифметика простая, и именно поэтому показательная: её нельзя заменить знанием названий.
Номер 12, про GitOps. Определение знают все. Уточняющий вопрос — «что произойдёт, если поправить Deployment руками через kubectl edit?» — знают те, кто жил с Argo CD или Flux: агент правку откатит. Отсюда вырастает разговор про срочные исправления на проде — в ответе это названо среди слабых мест подхода.
Номер 14, про observability. Здесь я смотрю на один пункт: «почему нельзя усреднять перцентили с нескольких экземпляров?» Рядом в ответе стоит и подсказка, зачем он нужен: время ответа измеряют перцентилями и гистограммами, а не средним. Знать слово «перцентиль» и понимать, что с ним можно делать, — разные вещи.
И отдельно про зомби, номер 42. Вопрос тот же, что в 2018 году, но в ответе появился пункт про контейнеры: PID 1 там — само приложение, чужих потомков оно не собирает, отсюда зомби и рекомендация использовать tini или --init. Старый вопрос, новая среда, тот же механизм.
Вопрос номер 50
Последний вопрос я не менял ни в 2018 году, ни сейчас: «С какой технологией ты познакомился вчера, на этой неделе, в этом месяце?»
Короткий ответ в файле звучит так: «Правильного ответа нет. У собеседника должна быть эмоция при ответе на этот вопрос». В 2018 году этим всё и ограничивалось — шестьдесят символов. Теперь там расписано, чем сильный ответ отличается от слабого: человек называет конкретную технологию, а не пересказывает заголовки, пробовал её руками, понимает, какую проблему она решает, и видит, где её применять не стоит.
Один пункт в этом ответе появился только в 2026 году: если кандидат рассказывает про AI-ассистентов и агентов, он должен объяснить, как проверяет результат их работы и что им не доверяет. По-моему, сегодня это самый короткий способ отличить инженера от оператора подсказок.
Как пользоваться списком
Если вы проводите собеседование. Пятьдесят вопросов за одно интервью не задать, и не нужно. Я бы брал десять-двенадцать: по два-три из каждой темы, которая важна для позиции. Начинать с короткого ответа, а дальше идти по уточняющим вопросам, пока кандидат отвечает уверенно. Где он остановился — там и граница.
Не стоит требовать ответ слово в слово. Раздел «сильный кандидат добавит» — не чек-лист на все пункты, а перечень того, что может прозвучать. Назвал два пункта из шести своими словами и объяснил, откуда знает, — это сильнее, чем шесть заученных.
Если вы готовитесь к собеседованию. Читать ответы подряд бесполезно: семьдесят тысяч символов за вечер не усвоить. Полезнее идти по уточняющим вопросам и честно отмечать те, на которые ответа нет. Их в списке 108, и ответов на них в файле нет — искать придётся самому. По-моему, это полезнее готового абзаца.
Если вы строите план обучения. Раздел «сильный кандидат добавит» — это 249 конкретных тем, сгруппированных вокруг пятидесяти базовых понятий. Из него получается готовая карта: что нужно знать сверх определения.
Ограничения
Говорю как автор, поэтому без скидок.
- Один файл. 952 строки без оглавления и без разделов по темам. Найти вопрос можно только поиском по странице. Разбивка по темам из этой статьи в самом репозитории не отражена.
- Нет уровней. Вопросы не размечены по грейдам. Какие из них для начинающего, а какие для ведущего инженера, решает тот, кто спрашивает.
- Облаков почти нет. AWS упоминается в файле один раз, остальные провайдеры — ни разу. Список про то, что работает одинаково где угодно: Linux, сети, контейнеры. Для позиции с конкретным облаком его придётся дополнять.
- Безопасность размазана. Отдельного блока нет: TLS, SELinux, секреты и краткосрочные токены разбросаны по разным ответам.
- Нет лицензии. В репозитории нет файла
LICENSE. Форкать и читать это не мешает, но формально условия использования не описаны. - Ответы короткие по замыслу. Это опорные точки для разговора, а не учебник. Средний ответ — около 1400 символов.
- Список стареет. Версия 2018 года устарела за восемь лет настолько, что её пришлось переписать. У этой срок годности тоже есть, просто он пока не виден.
Кому подойдёт
- Тимлидам и инженерам, которых позвали собеседовать и которые не хотят придумывать вопросы за пять минут до встречи.
- Кандидатам — как способ найти свои пробелы до того, как их найдёт интервьюер.
- Тем, кто переходит в DevOps из разработки или администрирования: по списку видно, какой объём знаний стоит за словом в названии должности.
- Не подойдёт тем, кто ищет задачи на живое выполнение — «почини упавший сервис», «напиши pipeline». Их здесь нет, это список для разговора.
Репозиторий открыт: https://github.com/olegbukatchuk/50-questions-to-devops. Если в ответе найдётся ошибка вроде той, с iptables-save, — pull request будет кстати. Одну такую я уже носил восемь лет.