 bukatchuk
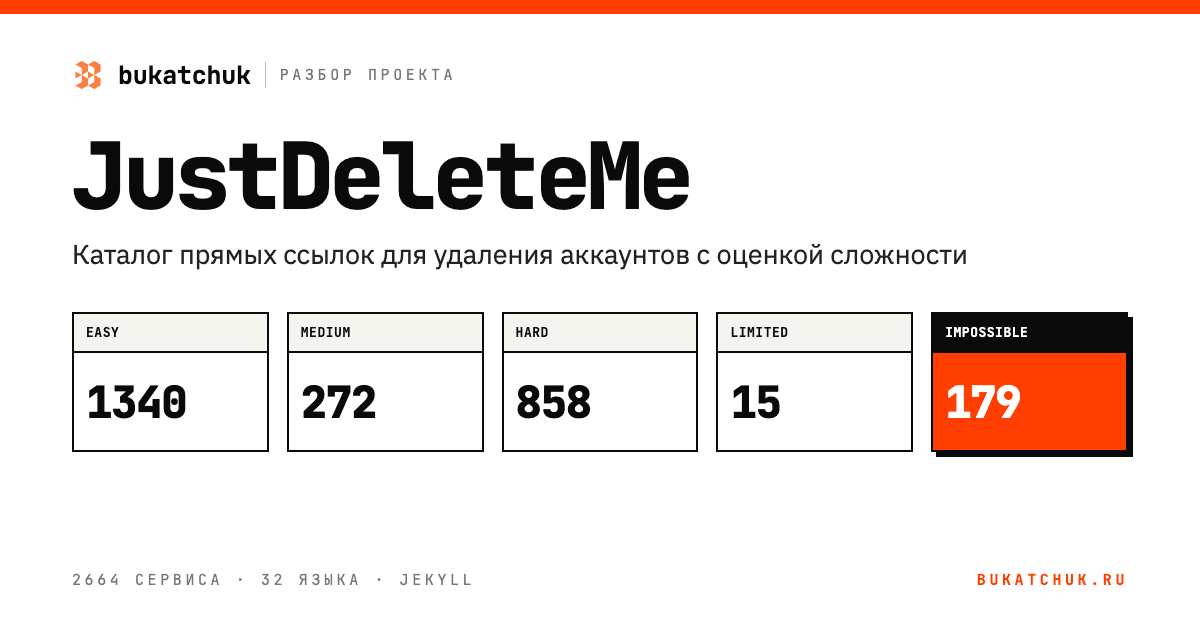
Зарегистрироваться в сервисе можно одной кнопкой с главной страницы. Кнопку «Удалить аккаунт» прячут куда глубже: в третьем уровне настроек, в справке или за формой обращения в поддержку. JustDeleteMe собирает такие страницы в один список: название сервиса, прямая ссылка на удаление, оценка сложности и короткая инструкция. Сайт работает по адресу justdeleteme.xyz, а весь каталог лежит в репозитории одним JSON-файлом.
Проекту тринадцать лет: первый коммит датирован 16 августа 2013 года, всего их 4172, из них 291 сделан с начала 2026 года. У репозитория 1368 звёзд и 480 форков. Нынешний репозиторий — самостоятельное продолжение исходного justdeleteme/justdelete.me, который автор перестал вести.
Я разобрал ветку master по состоянию на 7 октября 2026 года (коммит 49c3bd1): прочитал код, пересчитал файл каталога, собрал сайт локально и сравнил результат с живым justdeleteme.xyz. Скрипты проверок из репозитория я читал, но не запускал. Ниже — как устроен каталог, что проверяет CI и что он пропускает, чем публичный сайт отличается от собранного из исходников и стоит ли каталогу доверять. Забегая вперёд: данным — с оглядкой, идее — вполне.
Что это и из чего состоит
Проект — статический сайт на Jekyll без серверной части и без базы данных. Репозиторий небольшой:
| Часть | Где лежит | Что делает |
|---|---|---|
| Каталог | _data/sites.json |
2664 записи о сервисах, 1,27 МБ |
| Переводы интерфейса | _data/trans/*.json |
32 файла по 47 строк |
| Страницы языков | _pages/*.html |
33 файла из четырёх строк каждый |
| Шаблон | _includes/, _layouts/ |
шапка, список, подвал |
| Скрипты страницы | assets/js/ |
поиск, фильтры, выбор языка |
| Проверки | script/ |
валидатор JSON, проверка ссылок, сборка |
Четыре строки на страницу — не опечатка. Страница языка — это только шапка с кодом языка:
---
layout: default
lang: ru
---
Всё остальное шаблон берёт из данных: проходит по sites.json и для каждой записи выводит карточку, а подписи достаёт из файла перевода по коду языка. Для арабского, персидского и иврита в шапке стоит rtl: true, и шаблон добавляет dir="rtl". Мне такая экономия нравится: править приходится данные, а не вёрстку.
Как устроена запись каталога
Раз весь проект — один файл, смотреть надо в него. Одна запись выглядит так:
{
    "name": "GitHub",
    "url": "https://github.com/settings/admin#:~:text=Delete%20account",
    "difficulty": "easy",
    "meta": "popular",
    "notes": "Click on 'Delete account' near the bottom of the page and follow the instructions. Some user content will continue to exist anonymously on the website.",
    "domains": ["github.blog", "github.com", "docs.github.com", "support.github.com"]
}
Обязательных полей четыре: name, url, difficulty, domains. Остальные по необходимости:
notes— инструкция и последствия удаления; поддерживает Markdown;email,email_subject,email_body— если удаление идёт через письмо, страница соберёт готовую ссылкуmailto:с темой и текстом;url_КОДиnotes_КОД— ссылка и инструкция для конкретного языка;meta: popular— пометка для кнопки «Популярные». ВCONTRIBUTING.mdэто поле не описано, но валидатор его принимает.
Поле domains сайту нужно для поиска, а главное — для браузерных расширений: по нему расширение узнаёт, что открыт сервис из каталога.
Я пересчитал файл. Вышло так: 2664 сервиса, 6190 доменов, у 2242 записей есть инструкция, у 486 — адрес для письма, 35 помечены как популярные. Больше всего доменов у Википедии — 331, по одному на каждый языковой раздел.
Пять уровней сложности
Ссылка — половина записи. Вторая половина — оценка: насколько трудно будет уйти. Оценок пять. Определения я взял из CONTRIBUTING.md, распределение посчитал по файлу:
| Оценка | Что означает | Записей | Доля |
|---|---|---|---|
easy |
есть кнопка удаления | 1340 | 50,3% |
medium |
удаление есть, но требует дополнительных шагов | 272 | 10,2% |
hard |
нужно обращаться в поддержку | 858 | 32,2% |
limited |
удаляют только жителям стран с законами о защите данных и требуют это подтвердить | 15 | 0,6% |
impossible |
полностью удалить аккаунт нельзя | 179 | 6,7% |
Половина каталога — простые случаи. Но треть сервисов удаляет аккаунт только через поддержку, а 179 не удаляют вовсе. Эта таблица, по-моему, говорит о состоянии дел больше, чем любая отдельная запись.
Среди 35 популярных сервисов оценки такие: 19 — easy, 11 — medium, один — hard (Yelp) и четыре — impossible. Эти четыре — Blogger, Teams, Uber и Википедия. Причины разные и видны в заметках. Blogger и Teams нельзя удалить отдельно от аккаунта Google и Microsoft. У Википедии удаление невозможно из-за лицензии: правки должны сохранять указание автора. Про Uber в заметке сказано, что аккаунт должен исчезнуть через 30 дней после запроса, но этого не происходит.
Оценку ставит автор pull request. Правила требуют при изменении сложности существующей записи объяснить причину или дать источник, но проверить это автоматически нельзя. Так что оценка — это мнение человека, который добавил запись. Я к этому ещё вернусь.
Поиск, фильтры и выбор языка
С данными понятно, теперь о том, как их показывают. Вся работа со списком идёт в браузере, в 160 строках assets/js/scripts.js на jQuery. Код короткий, и странностей в нём на удивление много.
Поиск живёт в адресе. Введённый запрос через 250 миллисекунд записывается в хеш адреса, а обработчик hashchange скрывает карточки, которые не подошли. Совпадение ищется как подстрока в трёх местах: в названии, в адресе ссылки и в списке доменов. Поэтому работает ссылка вида https://justdeleteme.xyz/#github — её можно сохранить или отправить. На том же основан файл opensearch.xml: каталог добавляется в браузер как поисковая система. Это лучшее решение во всём скрипте: просто и с пользой.
Фильтры не складываются. Каждый фильтр сначала показывает все карточки, а потом скрывает лишние. Выбрать одновременно букву и сложность нельзя, поиск тоже сбрасывает фильтр.
Фильтр сложности сравнивает переведённый текст. Он берёт подпись из пункта меню и ищет её подстрокой в подписи карточки. Я бы сравнивал значение difficulty, а не подпись, и вот почему. В двух переводах одна подпись входит в другую: в чешском «Těžké» (сложно) — часть «Středně těžké» (средне), в шведском «svår» — часть «medelsvårt». На этих двух языках фильтр «сложно» покажет и записи со средней сложностью.
Фильтр по букве покрывает латиницу и цифры. Шесть сервисов начинаются с других символов — «/e/», «ÖBB», «Мій Клас», «РешуОГЭ/РешуЕГЭ/СдамГИА» и ещё два — и находятся только поиском.
Язык выбирается на корневой странице. redirect.js читает navigator.language и переходит на страницу языка. Сначала ищется точное совпадение или совпадение первых двух букв, и берётся первый подходящий код из отсортированного списка. Для пары вариантов одного языка это даёт неожиданный результат: браузер с pt-PT попадёт на pt-BR, а с zh-TW — на zh-CN, потому что они стоят в списке раньше. Нужный вариант остаётся выбрать вручную в меню языков.
Переводы на 32 языка
Чешский и шведский фильтры подвёл перевод, так что на переводы стоит посмотреть отдельно. Перевод интерфейса — файл _data/trans/КОД.json с 47 строками. Валидатор требует, чтобы в каждом файле были ровно эти ключи и в алфавитном порядке, поэтому пропустить строку нельзя: недостающие заполняются английским текстом. Получается перевод, полный по форме, а по содержанию — как повезёт. В арабском, румынском и упрощённом китайском по 17 строк из 47 совпадают с английскими, в польском и тайском — по 16. В русском таких три.
Файл TRANSLATION_REFERENCE.md объясняет, где на странице стоит каждая строка. Ключ androidapp в нём не описан, хотя обязателен.
Перевод инструкций к сервисам — отдельная работа, и распределена она неравномерно. Турецких заметок notes_tr в каталоге 519, французских 191, бразильских португальских 179, итальянских 120, немецких 110, испанских 93, русских 89. У остальных языков — не больше 52. Если перевода заметки нет, показывается английская. Ссылок для конкретного языка меньше: французских 40, немецких 31, русских 9.
Новый язык добавляется двумя файлами: перевод в _data/trans/ и страница в _pages/.
Что проверяет CI и чего не проверяет
Каталог из 2664 записей пишут сотни людей. Что не даёт ему развалиться? В .github/workflows/workflow.yml четыре задания, они же запускаются локально скриптом script/cibuild.
Валидатор validate_json.rb — основная защита каталога. В нём 16 кодов завершения, проверка останавливается на первой ошибке. Проверяется:
- JSON разбирается;
- записи идут по алфавиту — без учёта регистра и ведущего «The»;
- у записи есть
name,url,difficulty,domains, а лишних полей нет; difficulty— одно из пяти значений;- коды языков в
url_КОДиnotes_КОДсоответствуют файлам переводов; - домены записаны без
www.иhttps://; - заметки разбираются как HTML без ошибок.
Список солидный. Но три вещи валидатор не ловит, и они показались мне важнее всего остального в разборе.
Схема ссылки не проверяется. Функция validate_url_schemes в файле есть и даже имеет свой код ошибки, но в списке проверок записи её вызова нет. Проверка написана, но не подключена. Я поискал, что из-за этого прошло в данные, и нашёл: у записи SoftCreatR Media в поле url_zh-CN лежит не адрес, а текст заметки на китайском. На странице упрощённого китайского этот текст стоит в атрибуте href карточки. Ещё 17 записей ведут на адреса с http://.
Дубликаты ищутся по полному совпадению записи. Два объекта с одним названием, но разными ссылками, проверку пройдут. Сейчас повторяющихся названий в каталоге нет.
Заметки не очищаются. Они проходят через фильтр markdownify, а он пропускает HTML как есть. Теги есть в 45 заметках, ссылки в Markdown — в 122. Проверка разбором отсеивает сломанную разметку, но не нежелательную. Единственный барьер между содержимым pull request и страницей — человек, который его принимает.
Остальные три задания проще.
Проверка ссылок ping_websites.rb обходит поле url в 20 потоков. Ответ 404 и сетевые ошибки пишутся в журнал, перенаправления не раскрываются, ошибка сертификата считается признаком живого сайта. Код завершения скрипт не выставляет, поэтому задание в CI зелёное при любом числе мёртвых ссылок. Ссылки из url_КОД не обходятся. Тут я авторов понимаю: это разумно для набора из 2664 чужих сайтов — иначе сборка падала бы каждый день. Но означает это, что битые ссылки нужно искать в журнале задания глазами.
Сборка run_jekyll.sh собирает сайт и запускает htmlproofer с проверками Images,Scripts,Favicon,OpenGraph. Проверка ссылок в этот список не входит.
Форматирование сверяется с .editorconfig командой npx @htmlacademy/editorconfig-cli. Только ради этого README называет Node.js зависимостью. Версия пакета не зафиксирована, файла package.json в репозитории нет — при каждом запуске из npm берётся последняя. Я бы версию зафиксировал: проверка стиля не должна тянуть в CI код, который вчера никто не видел.
Сборка в CI и сборка на сайте
Дальше выяснилось, что CI проверяет не совсем то, что публикуется. Gemfile требует Jekyll не ниже 4.4.1, а CI запускает всё на Ruby 4.0.4. Публикуется сайт иначе. По данным API GitHub у репозитория включён GitHub Pages с типом сборки legacy из ветки master. Отдельного workflow для публикации в репозитории нет. Встроенная сборка GitHub Pages использует собственный набор версий с Jekyll 3.10 и на Gemfile проекта не смотрит.
Выходит, что тесты проверяют одну версию генератора, а сайт собирает другая. Шаблоны простые, и расхождений в результате не видно: на живой странице те же 2664 карточки и те же 32 языка. Но проверка в CI не гарантирует, что страница соберётся так же при публикации.
Вторая особенность меня позабавила: в шаблоне используется |safe. Это фильтр из Jinja, в Liquid его нет. Jekyll по умолчанию молча пропускает неизвестные фильтры, поэтому строка выводится как есть и ошибки не возникает. Работает, но случайно.
Что уходит в сеть
Теперь главный вопрос для сайта, на который приходят за приватностью: что он сам знает о посетителе. По исходникам — почти ничего. Собранная страница грузит только свои файлы: две таблицы стилей, четыре скрипта и значки. В исходниках нет счётчиков посещений, сторонних шрифтов и обращений к CDN. jQuery лежит в репозитории, версия 1.10.2 от 2013 года.
- Поисковый запрос хранится в хеше адреса, а хеш на сервер не передаётся.
- Переход по карточке — обычная ссылка на сайт сервиса, без промежуточных страниц.
- Письмо открывается в почтовой программе через
mailto:; сайт его не отправляет и не видит.
Так выглядит сайт, собранный из исходников. Я сравнил его с публичным и нашёл три отличия.
- Сайт отдаётся через Cloudflare, и тот включает защиту адресов почты. На русской странице 538 ссылок ведут на
/cdn-cgi/l/email-protection#…, а в страницу добавлен скриптemail-decode.min.js. Без JavaScript кнопка «Отправить письмо» почтовую программу не откроет. В локальной сборке той же страницы таких ссылок нет: в ней 489 обычныхmailto:. - Принудительного HTTPS нет. Запрос к
http://justdeleteme.xyz/возвращает страницу с кодом 200, без перенаправления. В настройках Pageshttps_enforcedвыключен. Открывать каталог стоит по адресу сhttps://: на странице, полученной по HTTP, ссылки можно подменить по пути. Для каталога, который ведёт на страницы с вводом пароля, это, на мой взгляд, самое неприятное из трёх отличий. - Страница тяжёлая. Каждая языковая версия содержит все 2664 карточки и весит от 3,3 до 3,5 МБ HTML.
Отдельный канал — расширения. Дополнение для Firefox из той же организации скачивает sites.json прямо из ветки master с raw.githubusercontent.com и хранит его сутки. Принятый pull request попадает к пользователям расширения без выпуска новой версии. Сам сайт файл не публикует: justdeleteme.xyz/sites.json отвечает 404.
Установка и запуск
Раз публичный сайт отличается от исходников, логично собрать свой. По README нужны Ruby от 2.7.2 и Node.js. Шаги такие:
git clone https://github.com/jdm-contrib/jdm.git
cd jdm
gem install bundler
bundle install
bundle exec jekyll serve
README предлагает запускать просто jekyll serve; через bundle exec используются версии из Gemfile.lock. Jekyll по умолчанию слушает 127.0.0.1:4000, то есть копия видна только с того же компьютера.
Я собирал сайт на Ruby 3.3, и сборка прошла: версия 4.0 из CI для неё не нужна. Bundler ставит 56 гемов, сама сборка занимает около тридцати секунд — Jekyll 33 раза разворачивает шаблон на 2664 записи. В _site получаются 33 страницы (index.html, ru.html, de.html и так далее), opensearch.xml и папка assets, всего 104 МБ. Да, 104 МБ из каталога на 1,27 МБ.
Что стоит знать заранее:
- Lock-файл записан для двух платформ — Linux x86_64 и Windows. На macOS Bundler дописывает в
Gemfile.lockдевять строк: свою платформу и сборкиffi,nokogiri,google-protobufиsass-embeddedпод неё. В pull request это изменение включать не нужно. - Гемы ставятся с rubygems.org, зеркал и собственных реестров в проекте нет.
script/cibuildходит в сеть: проверка ссылок делает запрос к каждому из 2664 сервисов, а проверка форматирования скачивает пакет из npm. Для правки одной записи достаточноscript/validate_json.rb.- Фоновых процессов нет: после остановки
jekyll serveничего не остаётся.
Локальная копия полезна не только для разработки. Она не зависит от доступности сайта, открывается без сторонней прослойки и позволяет читать историю каждой записи через git log.
А можно обойтись и без сайта. Каталог — обычный JSON:
# запись по домену
jq -r '.[] | select(.domains | index("github.com")) | "\(.name): \(.difficulty) \(.url)"' _data/sites.json

# сколько сервисов в каждой категории
jq -r 'group_by(.difficulty)[] | "\(.[0].difficulty) \(length)"' _data/sites.json
Так каталог встраивается в свои инструменты: проверить список доменов из менеджера паролей и получить для каждого ссылку на удаление и оценку сложности. Мне этот способ кажется самым практичным из всех.
Как добавить сервис
Вклад сообщества — основа проекта: по данным API GitHub у репозитория 876 авторов коммитов. Порядок описан в CONTRIBUTING.md:
- Запись ставится в
sites.jsonпо алфавиту, с отступом в четыре пробела. url— прямая ссылка на удаление, а если её нет — на статью справки.- Шаги описываются в
notes. Если заметка повторила бы стандартную — «перейдите по ссылке и удалите аккаунт» дляeasy, «напишите в поддержку» дляhard— она не нужна: шаблон подставит текст сам. - При существенной правке заметки её переводы удаляются, если автор не владеет этими языками.
- Коммит называется
Add SERVICE as DIFFICULTYилиUpdate FIELD for SERVICE.
Для тех, кто не работает с Git, есть шаблон обращения с теми же полями.
Лицензии
Здесь без сюрпризов.
- Проект — MIT, правообладатели в файле
LICENSE: Robb Lewis, команда JDM Contrib и участники. - Значок выбора языка — Font Awesome, CC BY 4.0, с правками выравнивания.
- Поиск переделан из DevCenter.me — MIT.
- jQuery 1.10.2 — MIT; jQuery dropdown — двойная лицензия MIT / GPL v2.
Закрытых и собранных частей в репозитории нет: всё, что попадает на страницу, читается в исходниках.
Ограничения и риски
Теперь то, из-за чего каталогу стоит доверять с оглядкой.
- Ссылки устаревают. Сервисы меняют настройки, а автоматическая проверка только пишет в журнал. У записи нет поля с датой последней проверки; когда её правили, видно только в истории Git.
- Оценка сложности — мнение участника, а не результат проверки. Заметка «удаление не происходит» отражает опыт автора записи.
- Каталог ведёт на чужие сайты, где вводится пароль. Подменённая в pull request ссылка стала бы фишинговой, а защита от этого — только ручной просмотр. Перед вводом пароля стоит сверить домен в адресной строке с полем
domainsзаписи. - Изменение в
masterсразу расходится по сайту и расширениям — промежуточного выпуска нет. - Удаление аккаунта не равно удалению данных. Заметки у Facebook, Reddit, GitHub и Yelp прямо говорят, что часть содержимого остаётся. Каталог показывает, где кнопка, а не что произойдёт с данными после.
- Покрытие неравномерное. Русскоязычных заметок 89 на 2664 записи, турецких — 519.
- Клиентская часть не обновлялась давно: jQuery 2013 года, все карточки в одном документе на три с лишним мегабайта.
Итог: кому подойдёт
Что хорошо. Идея простая и доведена до конца: один открытый файл под MIT с понятной схемой, никаких счётчиков в исходниках, всё читается. Каталог живой — 291 коммит с начала 2026 года.
Что плохо. Защита данных слабее, чем выглядит: проверка схемы ссылки написана, но не вызывается, проверка ссылок всегда зелёная, а между pull request и страницей стоит только человек. Публичный сайт не требует HTTPS. Клиентская часть давно не обновлялась: jQuery там 2013 года.
Кому каталог нужен:
- Тем, кто чистит старые аккаунты. Список из менеджера паролей сверяется с каталогом за один проход, а сложные случаи видны заранее.
- Специалистам по безопасности и защите данных. Категории
hard,limitedиimpossible— готовый список сервисов, где удаление упирается в поддержку или в требование подтвердить страну проживания. - Разработчикам.
sites.json— открытый набор данных под MIT с понятной схемой; на нём уже построены расширения для браузеров. - Тем, кто выбирает сервис. Оценку сложности удаления полезно посмотреть до регистрации, а не после.
Кому он не поможет: тем, кто ждёт ответа на вопрос «какие данные хранит сервис». Каталог отвечает только на вопрос «где удалить». На этот случай в шапке сайта есть ссылка на родственный проект Just Get My Data.